你的 GPU 仪表盘在骗你
标准的 GPU 利用率指标,根本没测出它自己宣称要测的东西。下面我们会说明,什么才叫准确测量,并介绍一个能把这种测量能力带给每一个 AI 部署的开源工具。
太长不看版
你在 nvidia-smi、nvtop、rocm-smi、Weights & Biases、Amazon CloudWatch、Google Cloud Monitoring 和 Azure Monitor 里看到的那个 GPU 利用率数字,并不能告诉你 GPU 被压榨到了什么程度。它只能告诉你一件事:GPU 当时有没有在干活。就算真实计算吞吐只有 1%,仪表盘照样敢给你显示 100%。
这样一个极具误导性的数字,正在给整个 AI 行业带来源源不断的浪费——钱在浪费、电在浪费,还有大量根本没必要的硬件采购。
Systalyze 现已把 Utilyze 开源。它是一个免费、可以直上生产环境的监控与调试工具,能准确告诉你 GPU 真正有多少算力花在了“有效计算”上,以及对你当前这种负载来说,离现实中能摸到的性能天花板还有多远。Utilyze 可以几乎无感地与任何 AI 负载实时并行运行。在真实生产部署里,Utilyze 发现:很多被传统工具判定成“已经满载”的场景,实际上还有数量级的性能提升空间。
这件事的影响真实又直接。新硬件经常要好几个月才能到货,AI 带来的电力需求又把能源成本推得更高,每多花一块钱在没必要的 GPU 上,就少了一块钱可以投到模型身上。每多挖回一个百分点的真实吞吐,就意味着省下一笔钱、少上一架机柜、少耗一度电。
精准测量是一切优化的前提。而 Systalyze 就是建立在这套测量能力之上的优化平台,帮你把部署现状和理论可以达到的水平之间的差距,真正收窄。
现在就试试 Utilyze
AI 行业撞上了“测不准”问题
全球正站在一场 AI 算力危机的边缘。AI 集群的用电需求在急剧攀升,GPU 的交付周期已经拉长到了好几个月,而 NVIDIA H100 的一年期租赁合同价格,在 2025 年 10 月到 2026 年 3 月之间涨了近 40%。这种情况下,想靠“再买点硬件”来解决问题,既慢、又贵,而且对很多组织来说干脆走不通。
正因为 AI 算力如此稀缺,“优化”才成了几乎所有团队都在追求的硬目标。这也正是 Systalyze 在做的事:给 AI 系统做诊断和优化,提升 AI 工作负载的端到端性能。但我们在大量生产环境里反复看到同一个令人意外的现实:绝大多数团队根本不清楚自己的 GPU 跑得有多低效。他们觉得利用率很高,只因为仪表盘上写着“高”。
你想真正缩小性能差距,首先得能看见这个差距。把 GPU 利用率测准,不只是“有帮助”,而是任何有意义的优化的先决条件。而问题在于,今天大多数组织依赖的那个测量工具,本身就是错的。
具体来说,nvidia-smi、nvtop、rocm-smi、Weights & Biases(gpu.{i}.gpu)、Amazon CloudWatch、Google Cloud Monitoring 和 Azure Monitor 里那个 GPU 利用率,并不表示 GPU 被压榨到了什么程度。它测的只是:GPU 有没有在做点什么。
只要在采样窗口内,始终有至少一个内核在跑,这个指标就可能显示 100%。哪怕 GPU 实际只用到了理论算力的一丁点儿,甚至不到 1%,结论也一样。
对真实利用率缺乏洞察,会直接导致错误决策。比如团队会误以为现有 GPU 已经满载,于是跑去买更多 GPU;同时,也更难定位负载到底还有哪些可优化空间。
为了补上这个缺口,我们推出了 Utilyze(utlz)。它是一个免费、开源的工具,和现有监控工具最大的区别在于:它测的是 GPU 到底有多少效率真正花在了“有效计算”上,而不只是它有没有在活动;并且它可以实时在线给出这个结果,不会拖慢你的负载。除此之外,它还会告诉你,在当前这套硬件和模型组合下,现实中大概能跑到什么上限,好让你搞清楚,自己究竟是已经逼近极限,还是仍攥着大把性能没使出来。
“云厂商和硬件厂商也把这个误导性指标原样搬到了仪表盘里。当数字显示 100% 时,人们很自然会想:那我需要更多硬件了。至于为什么这种误解一直被默许存在……只能说,背后的利益关系相当微妙。”
— Manya Ghobadi,MIT 教授,Systalyze CEO
nvidia-smi 到底在跟你说什么
想理解为什么标准指标不够用,最好的办法就是看看它这个数到底是怎么来的。计算逻辑其实极其简单,而问题恰恰就出在这里。
GPU 会去采样一个二值信号:就在此刻,GPU 上到底有没有至少一个内核在被调度执行? 然后在一个采样窗口内(通常是 1 秒)对这个信号做平均。最后显示出来的百分比,就是在这个窗口里,答案为“有”的时间占比。
举个例:如果在 1 秒窗口里,只有一个内核跑了 400 毫秒,那么 nvidia-smi 就会报告 40% 的 GPU 利用率。
如果某个内核塞满了整个窗口,即便它只是一个很小的内核,只占用了某个流式多处理器(SM)上的一丁点儿资源,nvidia-smi 也会显示 100%。拿 H100 来说,它有 132 个 SM,每个 SM 里有 128 个 CUDA 核心和 4 个 Tensor Core,一共 17,424 个核心。换句话说,在 nvidia-smi 眼里,“1 个 CUDA 核心在忙”和“上千个 CUDA 核心一起满负荷跑”,本质上没区别。
这个指标诞生于更早的年代。那时候 GPU 主要跑图形渲染流水线,知道它是空闲还是活跃,确实已经很有用。图形负载要么有帧要渲染,要么没有,这种二元区分当时说得通。可今天的 AI 负载完全是另一回事:模型可以一直不停地跑在 GPU 上,同时却只用到了其实际算力的一小部分。这个指标却没能跟着时代一起更新。
更麻烦的是,这个局限会沿着整条监控链路一路传播。Weights & Biases 会自动把 gpu.{i}.gpu 记作系统指标,而这个值本身就来自 nvidia-smi。
主流云监控仪表盘也一样。比如 Amazon CloudWatch 的 GPU 监控,背后用的就是 nvidia-smi,指标名字甚至直接叫 nvidia_smi_utilization_gpu;GCP Monitoring 和 Azure Monitor 里对应的 GPU 利用率,本质上也都建立在同一个底层驱动计数器之上。AMD 这边也没好到哪儿去:rocm-smi 报告的,同样还是那套“有没有任何内核被调度”的指标。
证据:仪表盘全写着 100%,现实却可能只有 1%
现在很多工程师日常用的工具是 nvtop。它是一款开源 GPU 监控工具,同时支持 NVIDIA 和 AMD。底层实现上,NVIDIA 平台调 nvidia-smi,AMD 平台调 rocm-smi,所以它继承的也是同一套有问题的指标。
为了直观展示问题有多离谱,我们在一张 NVIDIA H200 GPU 上,循环跑了三组不同规模的方阵乘法:N = 256、N = 1024 和 N = 4096。每一次操作都是算两个 N × N 矩阵的乘积,同时分别用 nvtop 和 Utilyze 同步分析。
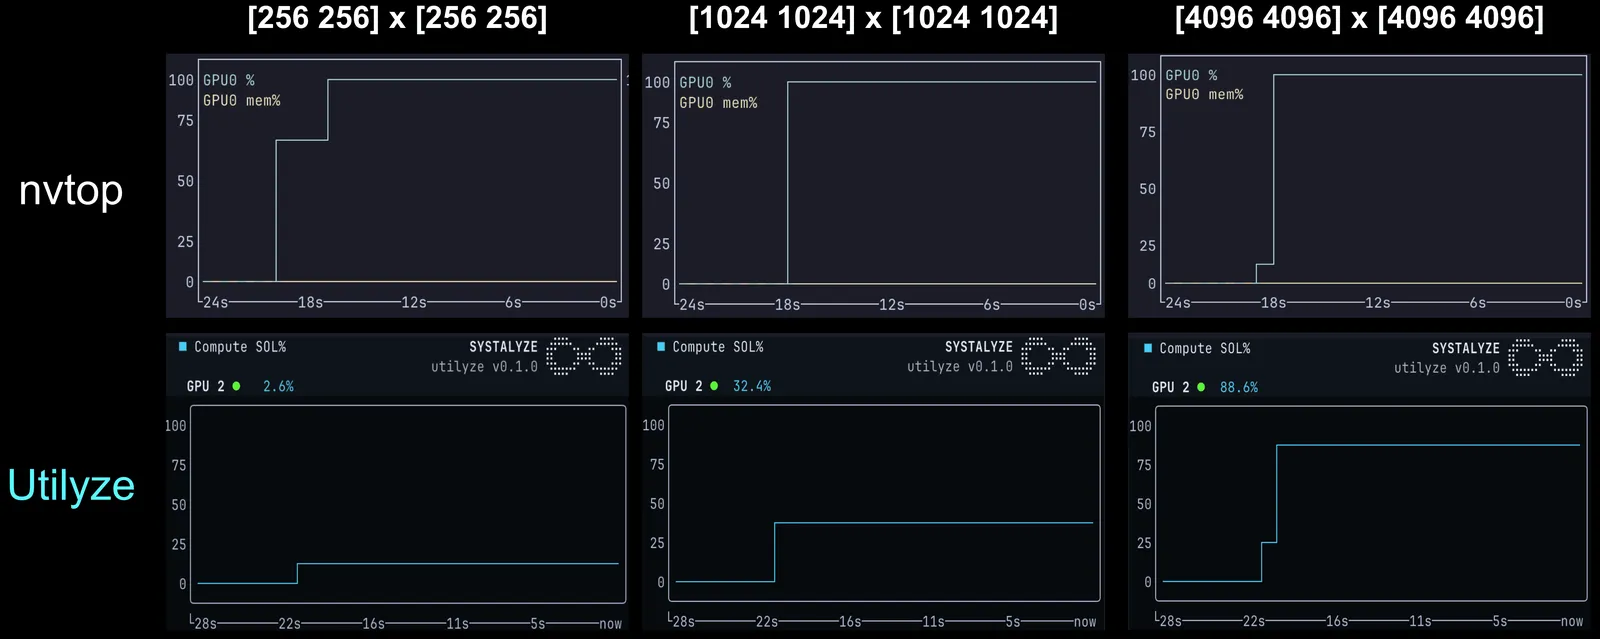
nvtop(上排)对三组负载全都显示 100%,根本不管矩阵大小。Utilyze(下排)跟踪的则是真实计算吞吐,矩阵规模不同,利用率差异一目了然。
如图所示,nvtop 对负载强度完全不敏感:三组矩阵乘法在 nvtop 上全部 100%(上排青色曲线始终贴顶)。但 Utilyze 显示,真实计算吞吐随着矩阵变大在不断爬升:N = 256 时约 2.6%,N = 1024 时约 32%,N = 4096 时约 88%。
要验证 Utilyze 的准确性,可以直接用理论算一下真实计算利用率。两个 N × N 矩阵做一次 TF32 精度乘法,需要执行 2·N³ 次浮点运算。再结合 H200 在 TF32 下的理论峰值 494.5 TFLOPS,并按 GPU 时钟频率缩放,就能得出利用率。
以 N = 256 为例:
-
2·256³ ≈ 0.034 GFLOPs -
每秒迭代次数为
155,349 -
因此实际吞吐约为
5.2 TFLOPS -
也就是大约
1%的利用率
同理可得:
-
N = 1024时约为32% -
N = 4096时约为86%
而 Utilyze 报出的结果,与这些理论“真值”的误差都在 2% 以内。
当然,对这种简单直接的矩阵乘法,手擼理论利用率还算可行。但对现实世界里的 AI 负载,这几乎不可能。现代训练、微调和推理流水线里,塞满了各种算子:注意力、归一化、通信、稀疏计算、控制流、动态形状,再加上 GPU 内部复杂的调度效应。到了这份上,你已经不可能再靠一阶原理手算出“真实利用率”了。
真正需要的是:一种能在硬件层面直接测量利用率的手段。
而这正是 Utilyze 能干的事。它通过 GPU 硬件性能计数器,直接测出真实的计算利用率。它从一个不同的方向出发,拿到了几乎一样的结果:不是从 FLOP 数量去推导利用率,而是直接在 GPU 上采样硬件计数器。两者之所以能对上,是因为它们丈量的是同一个物理事实,只是视角不同:实际完成的算术工作量 / 可用的算术能力上限。
这组交叉验证说明,Utilyze 基于硬件计数器的测量方法是准确的。到目前为止,还没有别的工具能在几乎没有额外开销的前提下,实时提供这种精度的测量。
“倒不是大家意识不到——真正写 CUDA 内核的工程师心里清楚,真实的利用率应该是什么样。缺的是工具。在此之前,还从来没有一种办法,能在不拖慢负载的前提下,在生产环境里持续、在线地看见真实的 GPU 效率。”
— Manya Ghobadi, MIT Professor & CEO, Systalyze
用 DCGM 计数器,也没好到哪去
此前已经有一些文章注意到了这个问题,并建议改用 NVIDIA Data Center GPU Manager(DCGM)暴露出的更丰富计数器,而不是死盯着 nvidia-smi。
其中最常见的代理指标是 DCGM 的 SM Active。它表示:在所有 SM 中,有多少比例的 SM 上至少驻留了一个 warp。
这个指标比 nvidia-smi 确实进步了一些,它好歹开始关心芯片内部的计算活动了,而不是把整块卡当成一个简单的“开 / 关”来看。但 SM Active,以及很多其他 DCGM 指标,本质上只是把同类问题往下沉了一层:某个 warp 驻留在 SM 上,并不等于这个 SM 正在做算术运算。
warp 可能一直在搬数据,也可能在等数据从内存里回来,或者只是跑一些簿记指令。即便如此,SM Active 照样能显示 100%。
Utilyze 解决的是更根本的问题:GPU 实际交出了多少接近峰值的算术吞吐?到目前为止,包括 DCGM 内在的现成工具,没有一个能在生产环境里持续给你这个答案。
为了说明这一点,我们在 H200 上跑了一个受内存带宽限制的负载,它的形态很接近以 decode 为主的大语言模型推理阶段。对这个负载而言,真实算术吞吐只有上限的大约 6%。
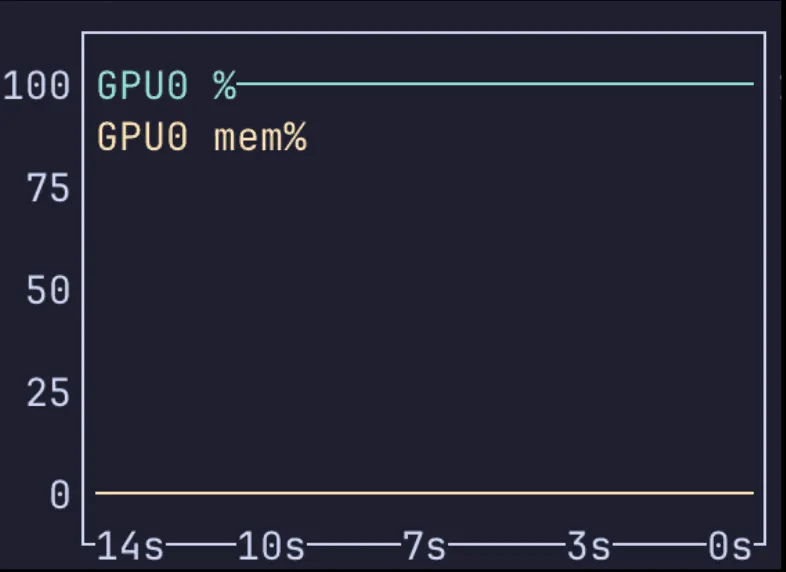
nvtop: 100%
理论真值: 6%
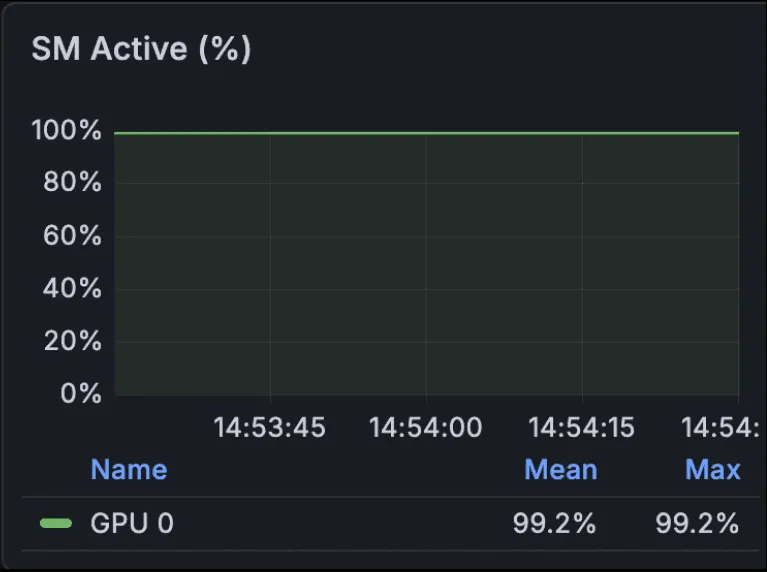
SM Active (DCGM):99%
理论真值: 6%
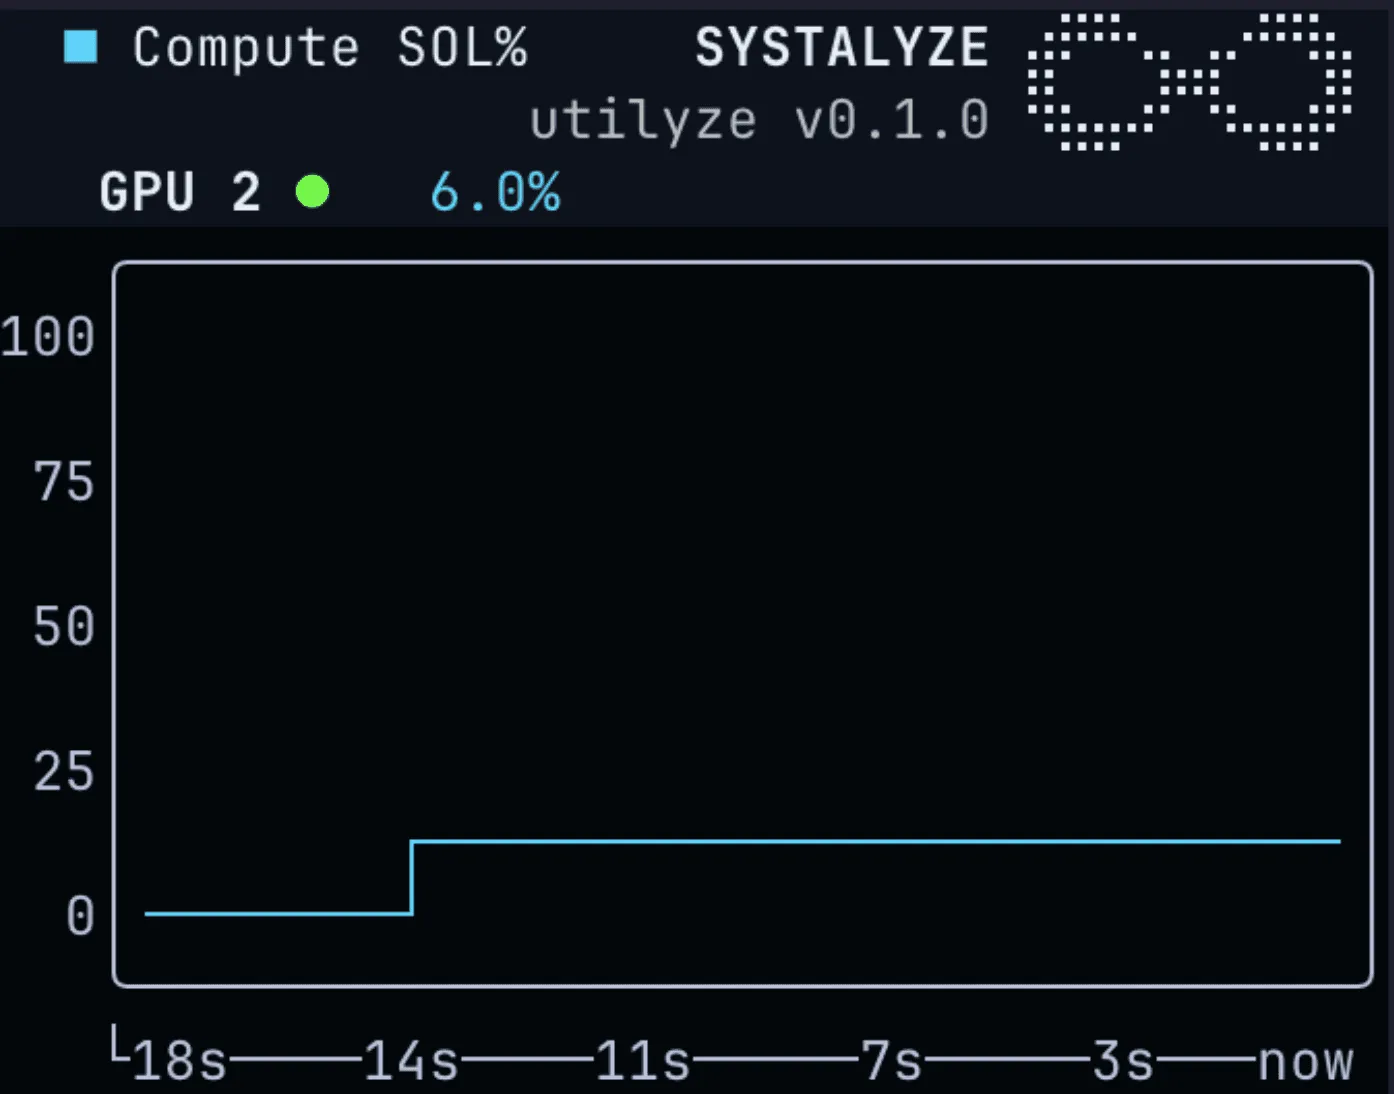
Utilyze: 6%
理论真值: 6%
只有 Utilyze 给对了。nvtop 错在哪,前面已经说过。SM Active 也会给出高达 99% 的“利用率”。确实,SM 上的 warp 整段时间都处于驻留状态,但这些 warp 并不是在做数学运算,而是在等内存;而 SM Active 分辨不出“在算的 warp”和“只在那儿等数据的 warp”。如果你拿 SM Active 来监控 GPU 利用率,就会产生一种错觉:看上去 GPU 已经跑满了,实际上计算单元大部分时间都在空转。
DCGM 还会报告其他指标,比如:
-
SM issue:指令发射频率
-
SM occupancy:SM 中 warp 的填充程度
-
Tensor Core 吞吐
但不管单独看还是拼在一起,这些指标都拼不出 Utilyze 那种完整图景。
Systalyze 开源发布的 Utilyze
我们把 Utilyze 设计成一款开源 GPU 监控工具,专门用来报告真实的 GPU 计算利用率和显存带宽利用率,并把它们表示成相对硬件理论极限的百分比。除了原始利用率,Utilyze 还会估算:在当前硬件、软件栈和 AI 负载组合下,理论极限里有多少是现实中真能达到的。
Utilyze 可以实时运行,几乎不带来额外开销,所以很契合生产环境:你既能持续观测系统,又不会因为监控本身而扰动性能。在 Systalyze 内部,我们一直拿它做监控、基准测试和性能优化验证,我们认为每个人都该用上它。
现在就试试 Utilyze
在解释 Utilyze 怎么实现之前,我们先拆开来说,为什么“准确衡量 GPU 利用率”在技术上是个难题。
GPU 有两类本质不同的计算资源:
-
CUDA 核心:负责通用浮点计算
-
Tensor Core:负责矩阵乘法
同时,它还有多层存储:
-
HBM(高带宽显存),位于芯片外
-
L2 缓存
-
每个 SM 内部的共享内存
-
每个线程本地的寄存器
这些资源,都可能分别成为瓶颈。一个负载可以把 Tensor Core 用得很满,但显存带宽几乎闲着;也可能反过来。所以,想用一个单一百分比来概括这种二维现实,天然就不够。
因此,GPU 上的每一个 AI 操作,都受两个物理极限约束:
-
数学单元执行算术的速度,也就是计算吞吐
-
数据在内存和数学单元之间搬运的速度,也就是内存带宽
任何一个内核,最终都会先撞上其中一个天花板,而这就决定了它的最大可能性能。
这也就引出了真正能准确描述 GPU 利用率的框架:Speed-of-Light(SOL)模型。它是一套性能分析框架,用来衡量某个内核距离 GPU 的理论硬件上限还有多远,并给出两个关键数字:
-
Compute SOL % = 实际 FLOPs / 峰值 FLOPs
-
Memory SOL % = 实际带宽 / 峰值带宽
它源自经典的 roofline 模型。在 roofline 视角下,每个内核最终要么受计算限制,要么受内存限制;两个 SOL 百分比里,更高的那个决定了真正的瓶颈所在。
Utilyze 提供的,正是这套信息,而且是实时的。它有两个核心指标:
-
Compute SOL %
-
Memory SOL %
两者都会在线显示。分子来自对各个计算引擎(比如 Tensor Core、FP32 / FP64 / INT32 流水线)以及各个存储子系统(比如 HBM 带宽、L2、L1)的直接测量;只要 NVIDIA 提供了这些硬件单元相对于理论峰值的百分比,Utilyze 就能利用它们。分母则是对应的 SOL,也就是硬件峰值本身。
这两项合在一起,就能给你一幅准确、实时的 GPU 利用率图景,这是其他工具做不到的。如果计算值更高,说明你的负载是计算受限;如果内存值更高,说明你的负载是内存带宽受限,这时候优化重点就应该优先放在数据搬运上。
不过,事情还不止于此。光看 SOL % 还有一个很重要的问题,它自己不会告诉你:100% 并不是现实中能达成的目标。
以 H100 为例,理论峰值大约是:
-
2,000 TFLOPS 计算能力
-
3.4 TB/s 显存带宽
但现实里的 AI 负载,不可能真正跑到这个物理极限。内核启动本身有开销,数据得在不同层级的存储之间移动,线程同步要花周期,多 GPU 场景下 GPU 之间的通信也会占掉本可用于计算的时间。
对于 MoE 模型来说,把 token 路由到不同专家会引入不规则的内存访问模式,进一步拉低有效吞吐。这些都不叫“优化没做到位”,而是现实部署本身的结构性属性。
因此,每一个部署其实都有一个低于 100% 的天然上限,它由模型架构、硬件、并行策略和批大小共同决定。我们把这个上限称为 Attainable Compute SOL %,下文简称 Attainable SOL %。你当前的 SOL % 与 Attainable SOL % 之间的差距,才是你的优化空间;而 Attainable SOL % 与 100% 之间的差距,属于系统的物理现实,不是靠调参就能磨掉的。
打个比方:
-
如果你跑的是一个 120B 参数的推理服务,现在 Compute SOL % 是 30%,而 Attainable SOL % 是 35%,那说明你已经很接近极限了。
-
但如果 Attainable SOL % 是 65%,而你只跑到了 30%,那就意味着你还有 35 个百分点的性能可以回收。这时正确的动作,不是采购新硬件,而是先做优化。
为什么 Utilyze 不一样
性能工程师在排查 AI 负载性能问题时,通常会依赖两类主要工具。
第一类是 Nsight Compute (ncu)。它是一个内核级分析器,能报告详细的计算与内存吞吐指标,比如:Tensor Core 理论吞吐真正达到了多少、内存总线被顶到了多满、瓶颈到底在哪。
第二类是 Nsight Systems (nsys)。它是一个时间线工具,负责记录内核什么时候跑、不同内核之间如何交互。
但这两类工具都更适合离线分析,而不是做一个实时仪表盘。
ncu 之所以能那么细,是因为它会去“重放”每个内核:用不同计数器配置把同一个内核反复跑很多遍,再把结果拼起来。这种做法很有价值,但额外开销也很大,通常会把原始负载拖慢 10 到 100 倍,所以根本不适合线上流量。
nsys 倒是不会引入这么大的减速,但它压根不报告吞吐指标。它回答的是“发生了什么”,而不是“跑得有多高效”。
所以实际情况是:那些真正有经验的工程师,会把 ncu(或 AMD 上的 Omniperf)当成离线、逐内核调试工具,而不是拿来盯实时生产流量。
Utilyze 为了解决这个问题,走了另一条路:它基于 NVIDIA 的 Nsight Perf SDK,在多个时间窗口之间轮换采样 GPU 性能计数器。它不会去重放内核,而是在连续滚动的窗口中采样,再把结果聚合起来。因此,它的额外开销几乎可以忽略,同时又能源源不断地测量。你可以把 Utilyze 和任何生产环境里的 AI 负载一起跑,并实时得到有意义的数据。
Utilyze 基准示例
下面给几个例子,看看怎么用 Utilyze 在真实 AI 负载里识别性能瓶颈。
场景 1:以 prefill 为主的大语言模型推理
先看一个推理负载:在 2 张 H200 GPU 上,跑 vLLM 0.19 版本的 Llama-3.1-8B 模型。
我们先测一个 prefill 占主导的负载:
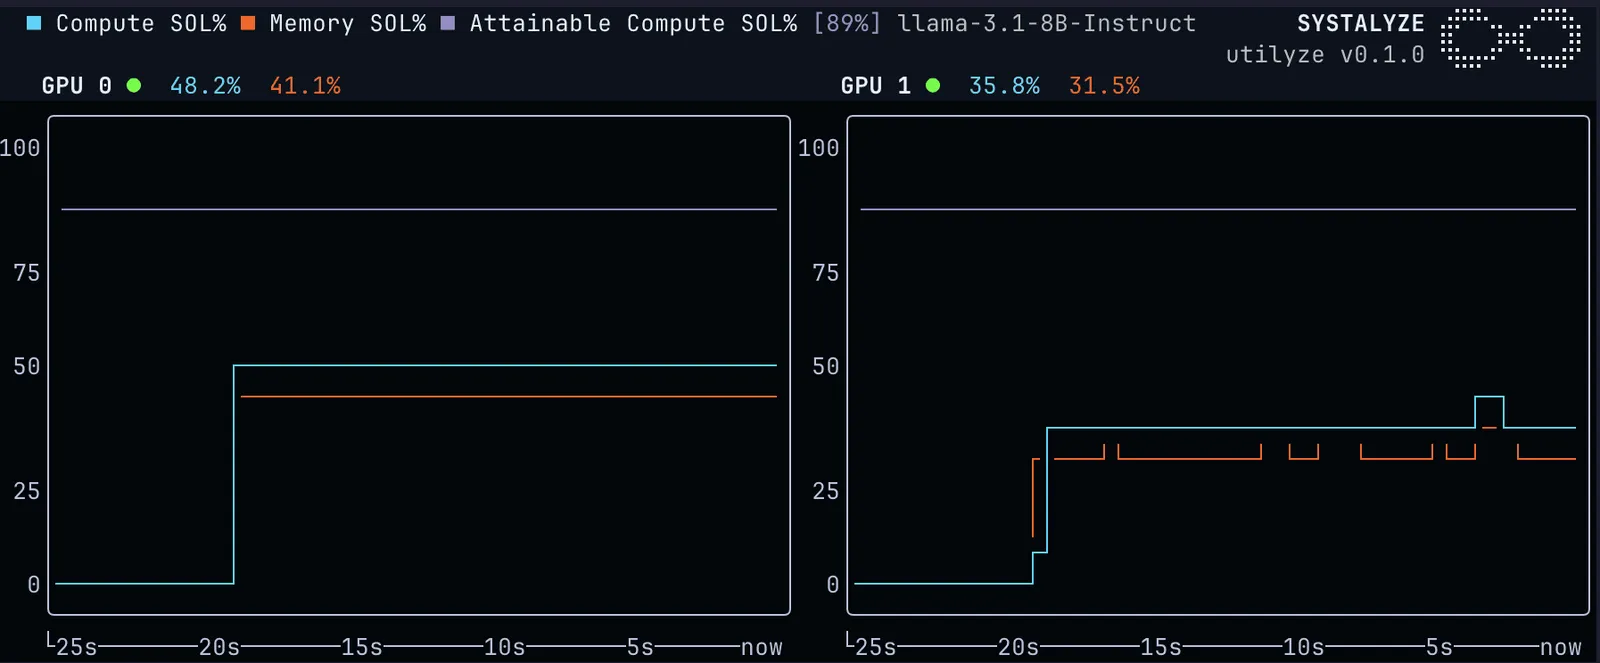
Utilyze 显示,这组负载下 GPU 的运行水平大概是理论上限的 45%,对应指标是 Compute SOL %。同时,Memory SOL % 比 Compute SOL 低,说明这个模型和负载当前并不是显存带宽受限,而是计算受限。这点在和以 decode 为主的推理负载对比时特别有用,因为 decode 场景通常是内存受限的。
此外,Utilyze 估计出这组负载的上限,也就是 Attainable SOL %,大约在 89%。
这个数是跟着模型、GPU 和具体负载走的。不同模型和不同工作模式,本身就会让 Attainable SOL % 不一样。Attainable SOL % 与当前 Compute SOL % 之间的差值,正好说明这块 GPU 目前还有不小的闲置空间。
再来看看 nvtop 的结果:
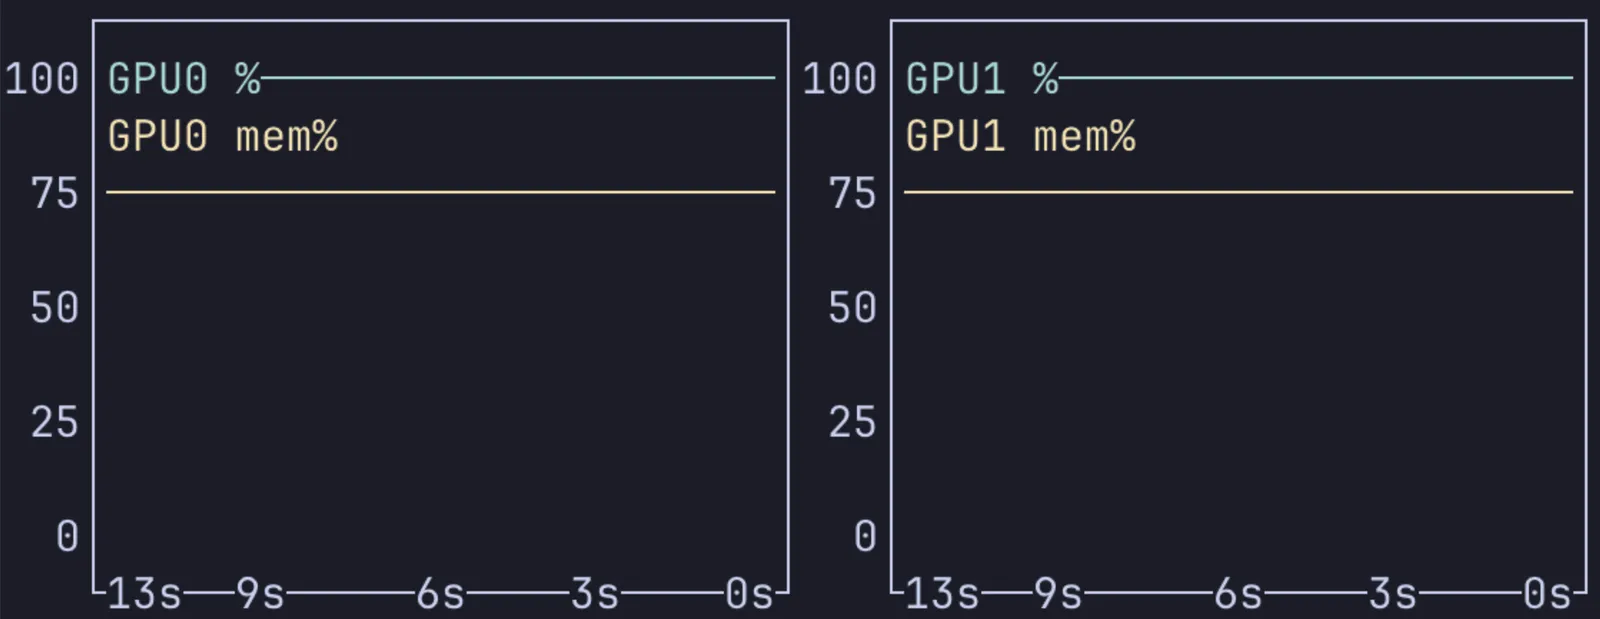
它从头到尾都显示 100%。如果你把这个数字当成 GPU 利用率去理解,就会得出一个完全错误的结论:GPU 已经跑满了,没啥可优化了。而 Utilyze 告诉我们,远不是这么回事。
接着,我们对同一个模型应用了 Systalyze 的优化,再跑同样的基准测试。
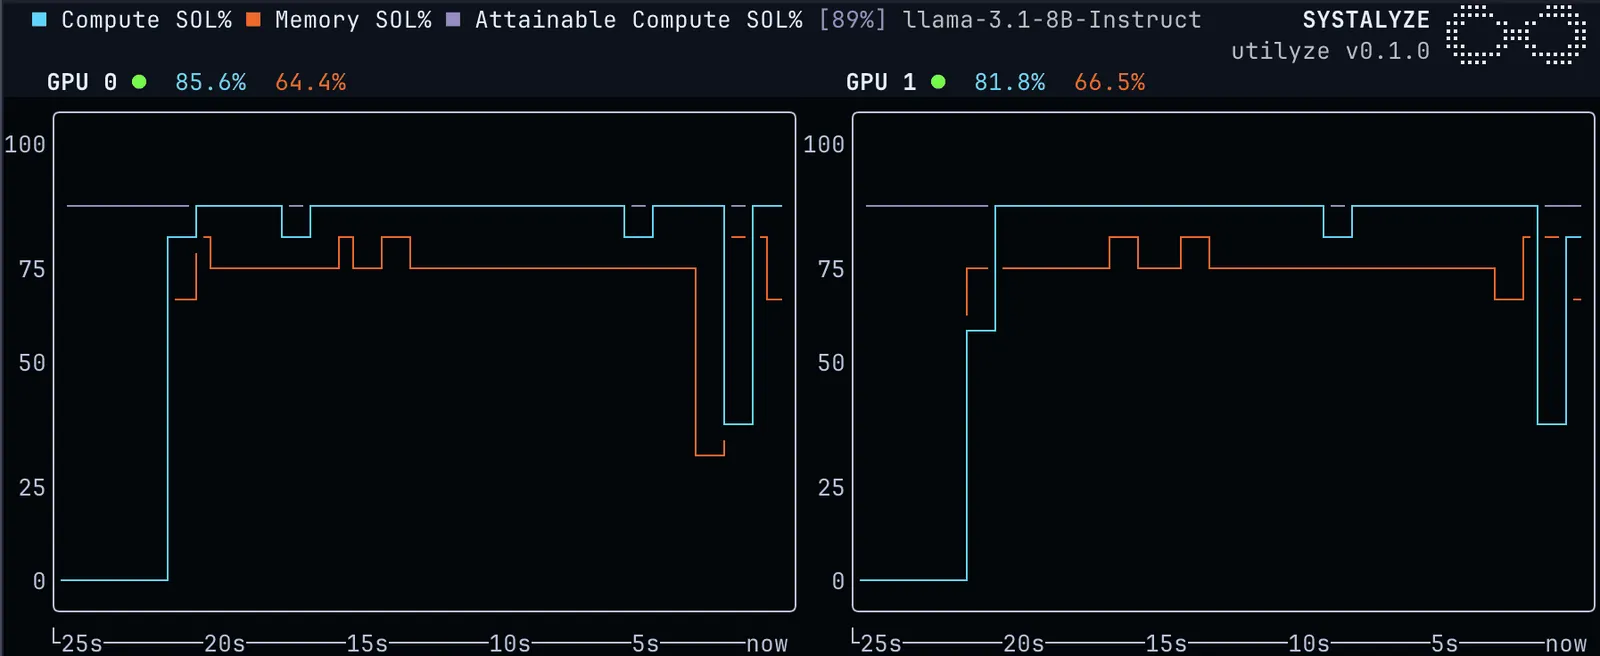
结果显示,新的 Compute SOL % 曲线已经逼近了 Attainable SOL %,也就是说,这块 GPU 几乎被推到了这个模型在当前条件下能到达的极限。吞吐数字也印证了这一点:优化前总 token 吞吐是 52,298 tokens/s,优化后达到 73,903 tokens/s,提升了 40%。
场景 2:以 decode 为主的大语言模型推理
在 decode 型推理里,Utilyze 的 GPU 利用率数字需要结合底层机制来理解。下面我们走几个不同场景,看看 Utilyze 是怎么帮助看懂 GPU 内部真实状态的。
先从同一个模型、未优化的 decode 型负载开始:
-
ISL = 1024
-
OSL = 4096
-
并发数 = 2
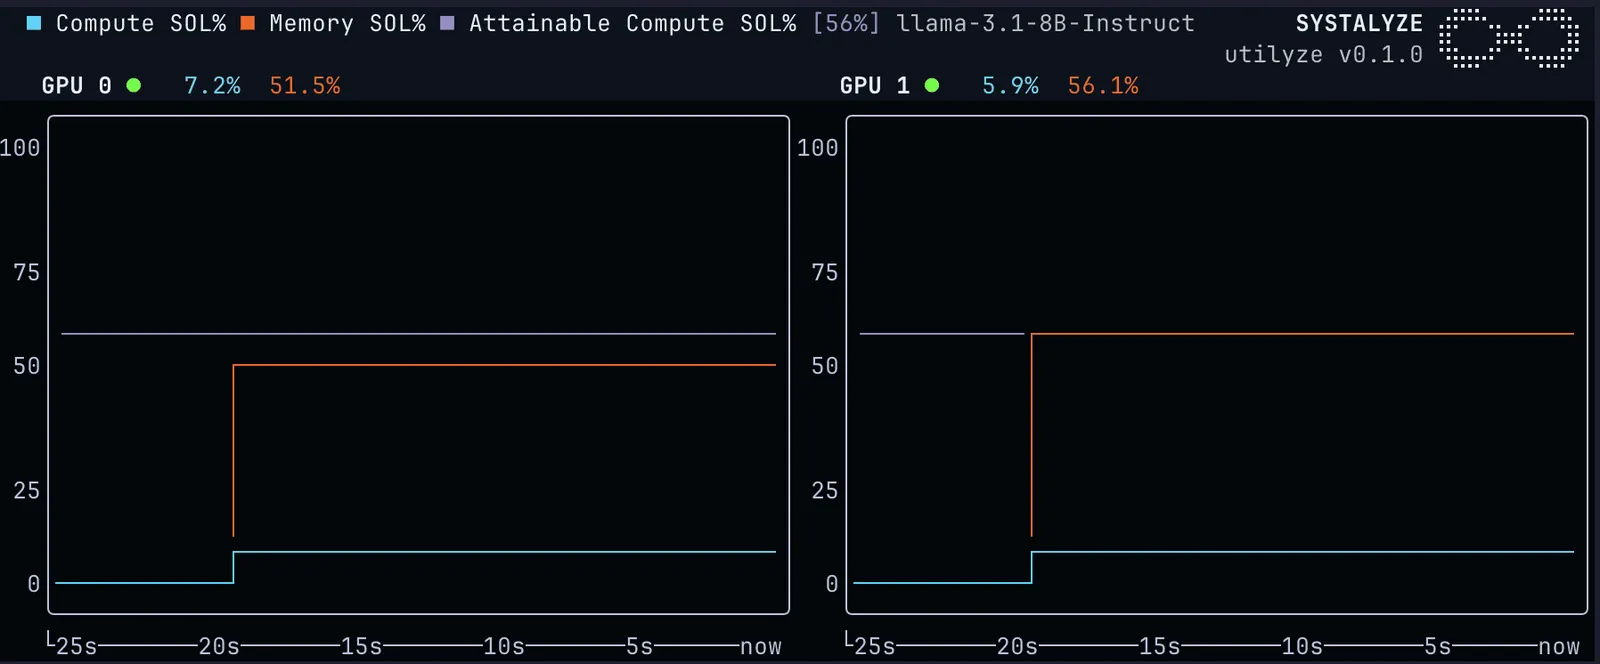
这时图里能看到:Memory SOL % 明显高于 Compute SOL %。这说明该负载受限于显存带宽,而不是计算能力。以 decode 为主的大语言模型负载,通常就是这个样子。因为每次解码一批 token 时,都需要把整份模型权重以及每个用户请求对应的 KV 缓存,从 HBM 搬到 GPU 的计算单元里。
接着,我们拉高并发,保持其他条件不变:
-
ISL = 1024
-
OSL = 4096
-
并发数 = 32
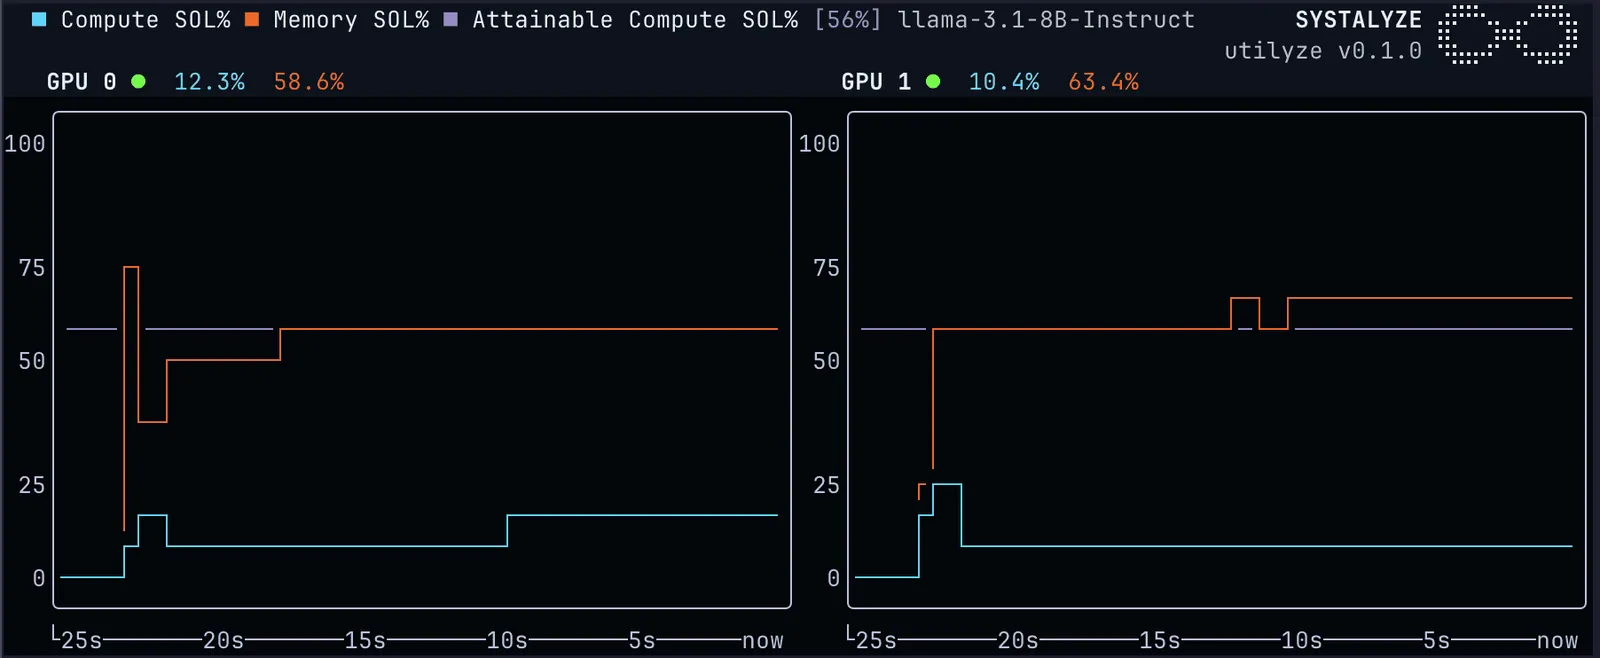
这时,Memory SOL % 和 Compute SOL % 都会往上走。
Compute SOL % 提高,是因为批大小变大了:对每批 token 来说,模型权重只需要从内存里读一次,于是单位批次里能摊出的计算量更多了。
Memory SOL % 提高,则是因为 GPU 总共需要从 KV 缓存中读取更多内容。
而且随着基准测试不断进行,Memory SOL % 还会持续上升,因为后面的 token 在做 decode 时,要读取的 KV 缓存会越滚越大。
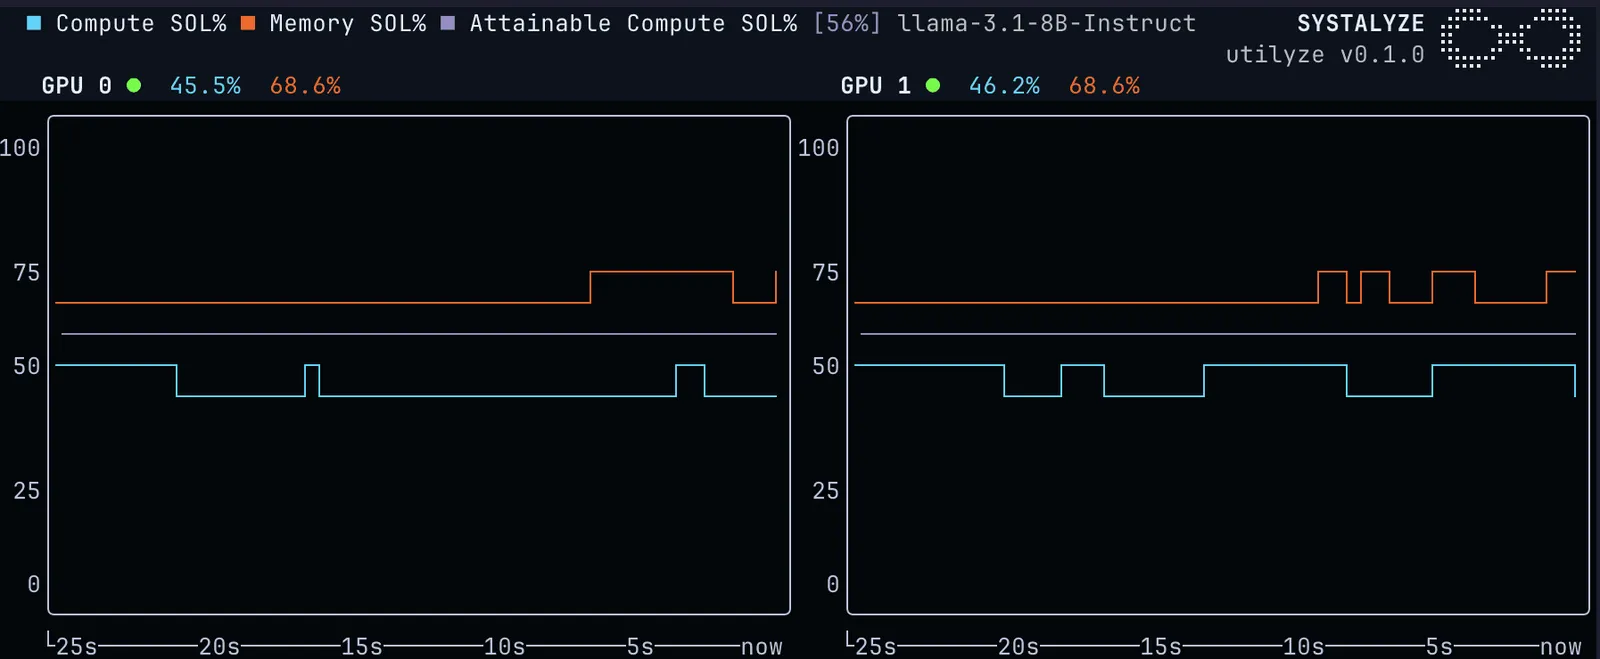
当我们更进一步,尽可能加大批处理,把并发拉到 1024 时,Compute SOL % 会接近 46%,几乎逼近 Attainable SOL %。
场景 3:大语言模型微调
再来看微调场景。我们使用 2 张 NVIDIA H200 GPU,对 Llama-3.1-8B 做 LoRA 微调,使用框架默认设置。
LoRA(Low-Rank Adaptation)是一种被广泛使用的参数高效微调方法。它不会更新全部模型参数,而是在每一层 Transformer 里插入小型、可训练的适配器矩阵,同时保持原始基础模型冻结不动。
整个训练循环会在下面几步之间交替:
-
对冻结的基础模型做前向传播
-
反向传播,计算适配器层的梯度
-
优化器更新,只更新这些适配器参数
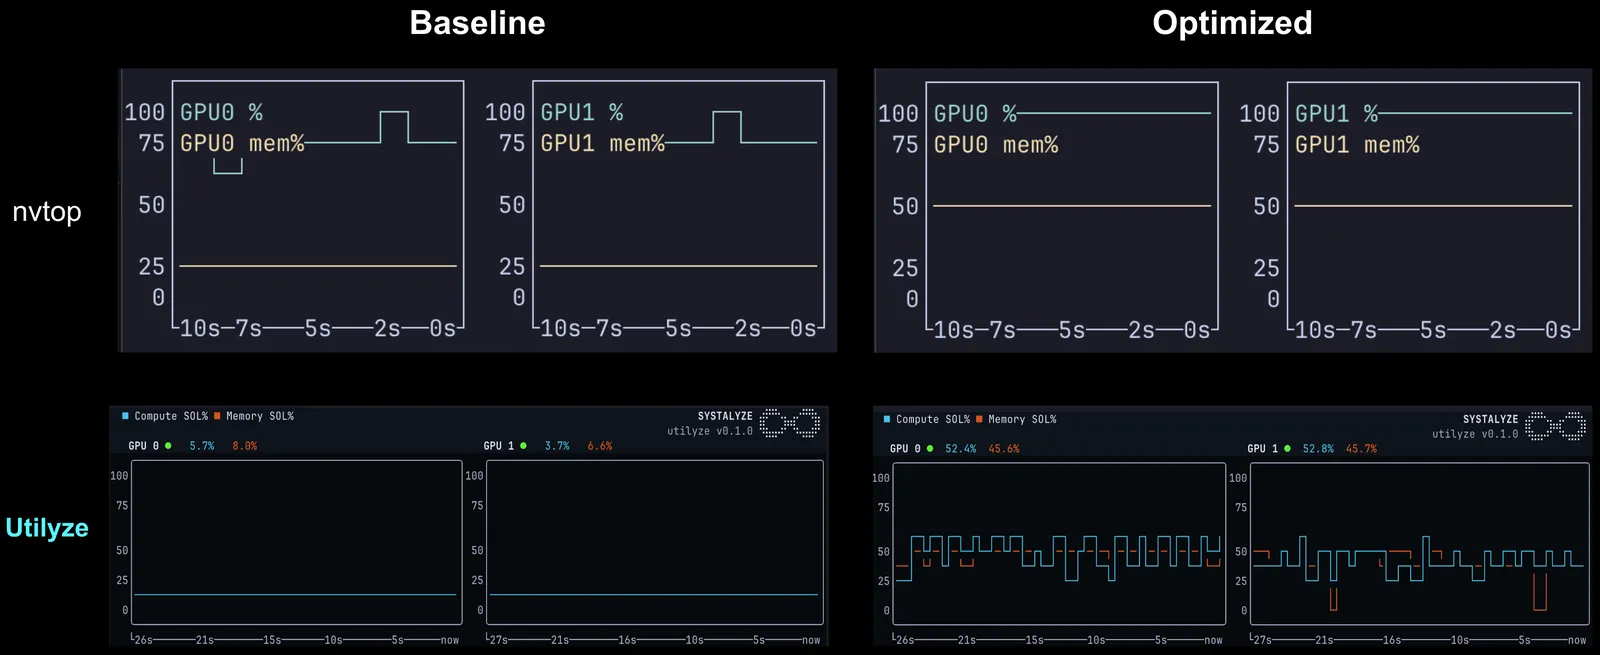
Utilyze 显示,在整个过程中,Compute SOL % 只有 1% 到 7%,远低于硬件理论上限;而 nvidia-smi 还是和前面一样,稳稳给出 80% 到 100% 的高估数字。
这种低 Compute SOL %,正是默认设置下 LoRA 微调的典型特征。要理解原因,就得看这些操作的算术强度。
前向与反向传播的主要成本,是在每一步训练中都要把冻结的基础模型权重从 HBM 里重新流过一遍。这些读操作规模很大,而且是顺序访问,对显存带宽来说其实相当高效;但它们每搬运一个字节所能产生的算术工作不多,因此这类负载天然就落在“内存受限”这一侧。
与此同时,LoRA 适配器层本身就特别小。典型 rank 也就 8 到 64,它引入的矩阵乘法规模太小,根本不够把 Tensor Core 喂饱。
最终的结果就是:训练期间 GPU 看起来一直在不停地发射内核,但 Tensor Core 很多时间其实并没有在做满计算,而是在等数据。这和前面以 decode 为主、受内存带宽限制的推理场景,本质上是同一种模式:从外面看 GPU 好像已经很“忙”,但从里面看,计算单元大部分时间都在闲着。
图中展示的就是这个负载在应用 Systalyze 优化前后的 Utilyze 输出。基线版本里,Compute SOL % 基本稳定在 1% 到 7%;优化后,Compute SOL % 被抬到了 40% 到 55%。这相当于真实 GPU 计算吞吐提升了 6 到 8 倍,而这种提升会直接反映在训练 step 时间上。底层算力本来就在那里,缺的是一双能看到它的眼睛,以及能据此动手优化的工具。
再来看一个更难的例子:在 4 张 NVIDIA H200 GPU 上,对 gpt-oss-20b 做全参数微调。gpt-oss-20b 是一个 MoE 模型,总参数量 20B,但每个 token 实际只激活其中 36 亿参数。这个模型单张 H200 装不下,所以训练框架会把参数、梯度和优化器状态切分到 4 张 GPU 上,并且每一步都要通信。
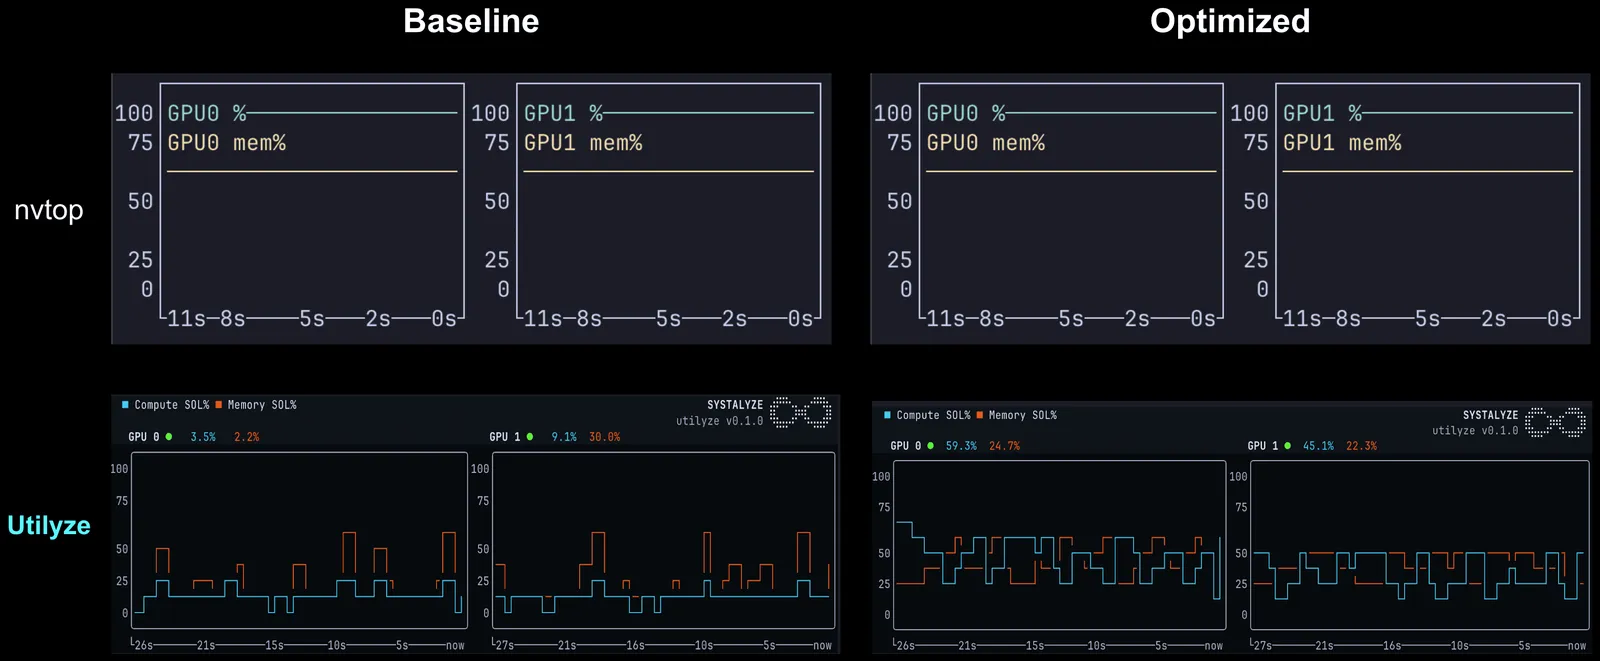
在基线版本里,Utilyze 报出的 Compute SOL % 始终只有 3% 到 15%;而 nvidia-smi 还是纹丝不动地显示 100%。
这种 Compute SOL %,正是 MoE 模型的典型表现。Tensor Core 偏爱又大又规整的矩阵乘法,但 MoE 喂给它的,是大量小而碎块的矩阵,每个活跃专家一块,再加上路由和 token 重排,GPU 很难被真正填满。
应用 Systalyze 优化后,利用率被推到了 30% 到 60%,这背后反映的是一种更适合 MoE 训练的实现方式。负载也从“完全受显存带宽限制”转变为“计算受限”。
当然,MoE 的稀疏性本身就意味着:它用更低的每 token 训练 FLOPs 和更小的每 token 激活代价,换来了较低的 GPU 利用率。所以这里较低的 SOL %,有一部分是架构天然带来的,并不全是调优不到位。
优化应该是一套持续的方法论,而不是出了事再打补丁
在 Systalyze 看过数百个生产部署之后,我们发现:优化从来不是“一次性修好就完事”的东西。模型会更新,流量模式会变,上个月还合适的批大小,今天可能就不对了;同一个部署在 A100 上和 H100 上的表现也会不一样。新的并行策略会冒出来,新的量化格式会发布,内核库也在持续演进。
因此,你当前 SOL % 与 Attainable SOL % 之间的差距,并不是一个恒定不变的数字。它必须被持续追踪。
那些真正能长期滚起收益的部署,依赖的是对真实 GPU 利用率进行持续而严格的测量;而那些默默劣化的部署,往往正是因为缺少这种测量能力。直到今天,这样的持续测量能力都还不是随手可得的标准配置。现有开源工具里,没有一个能对正在运行的负载给出既适合生产环境、又实时在线的 Compute SOL % 和 Memory SOL % 视图。Utilyze 把这把能力交到了每一个团队手上。
而 Systalyze 则是更上一层的那部分:它基于这些数据,来判断当前部署离 Attainable SOL % 还有多远、该上什么优化手段,以及每一种优化到底带来了多大的效果。
从测量走向性能:Systalyze
Utilyze 负责告诉你:你现在站在哪里。Systalyze 负责真正把差距补上。
它的平台建立在同一套 SOL 测量基础设施之上,能够自动识别:对于你的部署来说,哪种优化方式最有可能把系统推向它的 Attainable SOL %。这些优化包括但不限于:
-
CUDA Graph 编译
-
重写更高效的内核
-
并行策略选择
-
超参数调优
-
内核融合
-
零拷贝
-
绕过内核态的数据路径
-
更高效的作业编排
-
等等
而且,每一种优化都会通过它对 SOL 的实际影响来验证效果。
在各种各样的部署中——从十亿参数以下的推理模型,到万亿参数级别的顶尖模型;从公有云到本地部署——Systalyze 看到的共同现象都是:默认配置通常会把 2 到 10 倍的性能白白扔在桌上。只要用准确测量来引导,配上合适的优化组合,就能把其中绝大部分性能捡回来。
我们希望社区一起做什么
Utilyze 是一个免费、开源的项目,采用 Apache 2.0 许可证。
欢迎你把 Utilyze 跑在自己的负载上,分享你看到的数据,也欢迎告诉我们你的发现,尤其是那些“别的仪表盘画得漂漂亮亮,但 Utilyze 一量发现差得离谱”的情况。社区贡献的数据点越多,我们就越能更准确地校准不同模型架构、不同硬件代际、不同部署配置下的 Attainable SOL %。
如果你想分享结果,可以到 Utilyze 仓库 的 GitHub Discussions 里发帖,带上你的模型、硬件、基线 SOL %,以及你尝试过的优化方法。我们会积极查看并回复。若你想进行更深入合作,或者有企业级部署需求,也可以发邮件到 utilyze@systalyze.com。